从一次 18 万 Token 的失败,谈我的 Agent 可观测性实践
在把旅行规划 Agent 接入 TREK 时,我遇到的首要问题是:它经常超预算,却很难解释钱花在哪里。对话里只剩一段回答,看不到查询是否有效、哪些结果进入了下一轮,也无法把规划过程和地图上的变化对应起来。
我逐步补上了一套围绕 Session 的可观测性:持久事件日志、调用与计账关联、MCP 宿主记录,以及嵌在产品里的开发者页面。这篇文章分享其中的设计取舍。
本文写于 2026-10-08。截图均来自真实 Session,不是演示数据;它们来自不同运行和迭代版本。历史消耗用于说明诊断过程,不作为当前版本的优化成绩。
先用数据解释一次失败
2026-10-02 的审计中,一个“成都出发、四人自驾走完整 318”的任务累计消耗 181,276 Token,在进入独立复核前停止,尚未生成候选方案。
| 消耗项 | Token | 诊断结果 |
|---|---|---|
| 两次意图判断 | 2,057 | 明确的规划请求仍经历了两次判断 |
| 规划模型输入 | 154,426 | 累积历史、工具定义和查询结果持续进入上下文 |
| 规划模型输出 | 13,301 | 包含 8,228 reasoning Token,尚未完成方案 |
| 检索 embedding | 75 | 查询本身很小 |
| 检索 rerank | 11,417 | 西藏查询返回青岛材料,未支撑目标行程 |
| 独立复核 | 0 | 不能把这次超额归因于复核 |
进一步看输入,八轮规划中每轮工具定义有 11,746 字符,最后一轮工具返回历史有 40,410 字符。另有 11 次路线查询,10 次因坐标参数不符合接口要求而失败。
这些数字让我优先修正工具契约、无关检索和上下文累积,而不是直接压低预算。
提供方只回报整次请求的 Token,输入组成只能精确到字符数。字符数不能冒充某个 prompt 片段的 Token。
Session 是什么范围的唯一事实源?
我的定义是:Agent 工作及相关旅程变更的持久事实源。 TREK 的数据库仍负责当前业务状态;任务表、执行断点和页面都是不同用途的状态或投影。
事件至少有 session_id、seq、kind、task_id、payload 和时间。Session 内递增序号用于稳定排序;模型、工具与回执再用 call_id 关联,模型重试以 attempt 区分。
记录范围包括用户补充、实际模型请求与响应、工具参数与结果、缓存、预算、阶段边界、工作状态、草稿和页面变更。数据库触发器禁止日常修改或删除已写入事件。
但序号连续不等于事件完整。重建必须检查原生快照基线及变更水位;缺少基线时明确报告不完整。重建也不是重新调用模型,更不能保证再次生成同一个答案。
页面操作也必须进入记录
只记 Agent 的工具调用,会漏掉用户在原生页面上的修改。我在业务提交边界写入包含 before/after 的 Outbox,再投递到 Session:
这提供可重试、可去重的投递。网络失败不清空待投递记录,业务事务回滚也不会留下“已经修改成功”的假事件;它不是跨数据库的瞬时一致。
在 MCP 宿主统一记录具体工具调用
工具契约由服务器定义,宿主通过 tools/list 发现工具、通过 tools/call 调用工具。这与 MCP 的工具协议一致。
我的宿主统一处理连接、路由、角色权限、日志、缓存和调用预算。记录粒度是每一次具体工具调用:能看到服务器、远端工具名、参数、返回、耗时和错误,而不只是“调用了一次 MCP”。服务器内部的每个 HTTP 请求没有全部展开成 Session 节点。
{
  "kind": "tool_call",
  "payload": {
    "call_id": "tool_example",
    "server": "sources",
    "name": "query_places",
    "remote_name": "query_places",
    "arguments": { "keywords": "栈桥", "city": "青岛", "limit": 5 },
    "role": "plan"
  }
}
以上只是精简结构示例,实际参数必须满足服务器 schema。工具返回还保留原始 MCP 结果、解析结果、原始来源和缺失项。协议成功、业务有结果、足以支持规划,是需要分别判断的事情。
从事件生成执行图,而不是请模型画图
执行图由真实记录转换为 Mermaid flowchart,再渲染为 SVG。节点合并同一次模型调用的请求、响应与用量,保留失败尝试;连线根据已记录的调用 ID 建立。
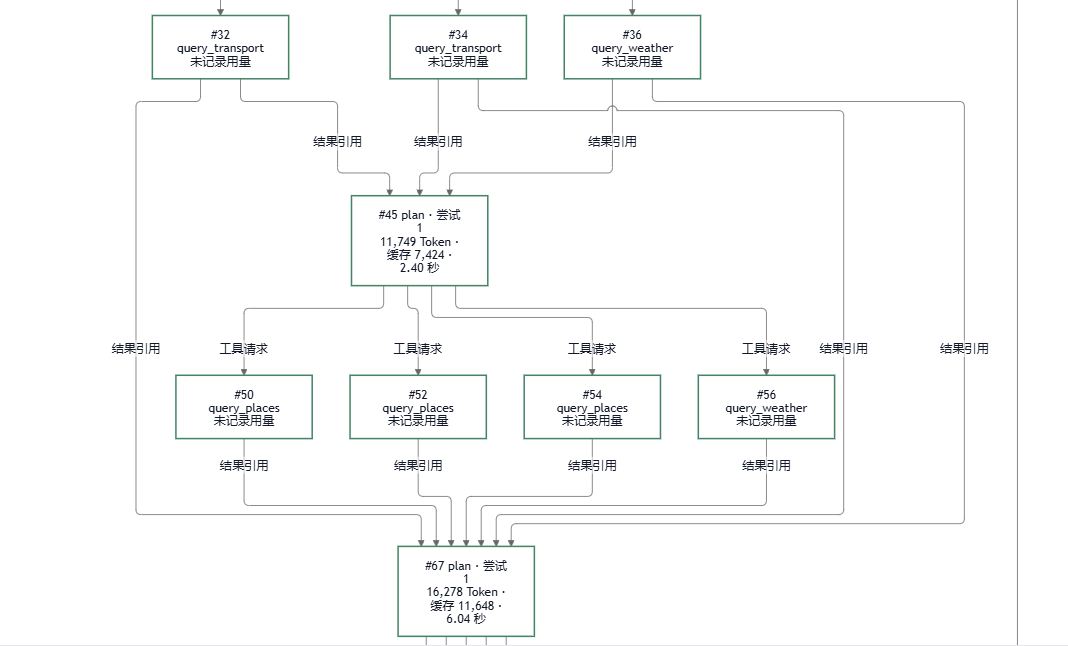
真实调试截图。#45 为 11,749 Token,其中缓存输入 7,424;#67 为 16,278 Token,其中缓存输入 11,648。它们与开头的 318 案例不是同一次运行。
图里的“结果引用”有一个很具体的含义:该工具结果作为 tool_call_id 对应的消息,进入了这次模型请求。它不证明模型理解正确,也不等于又执行了一次查询。
同一历史结果可以供多轮规划使用。图中的并列分支表示同批工具请求;仅凭它不能断言服务端真正并发执行。虚线只表达时间顺序,不把相邻事件伪装成因果关系。
三种复用,三套记录
工具缓存减少外部查询;提供方缓存减少重复输入的成本;恢复复用避免中断后重做已完成工作。我分别记录 cache_hit、model_response_reused 和 tool_result_reused,避免混为“省了多少 Token”。
完整事实留在 Session,模型每轮只拿当前相关的投影。例如路线几何交给地图,耗时和限制交给规划模型;上下文压缩记录压缩前字符数及压缩后的投影,在安全边界进行。
Token 账本依据提供方回执。缓存输入属于输入的子集,reasoning 属于输出的子集,都不能重复相加。响应、用量回执和任务计账在同一事务提交,用调用 ID 与尝试次数避免重复入账。失败请求缺少回执时,不能推断费用为零。
预算是执行护栏。我保留每任务初始额度和长期最高额度,记录扩额及拒绝;开发者页可调整长期上限,保存不会自动重启任务。一次在途请求可能越过阈值,返回后仍需如实计账。
把可观测性放进日常测试流程
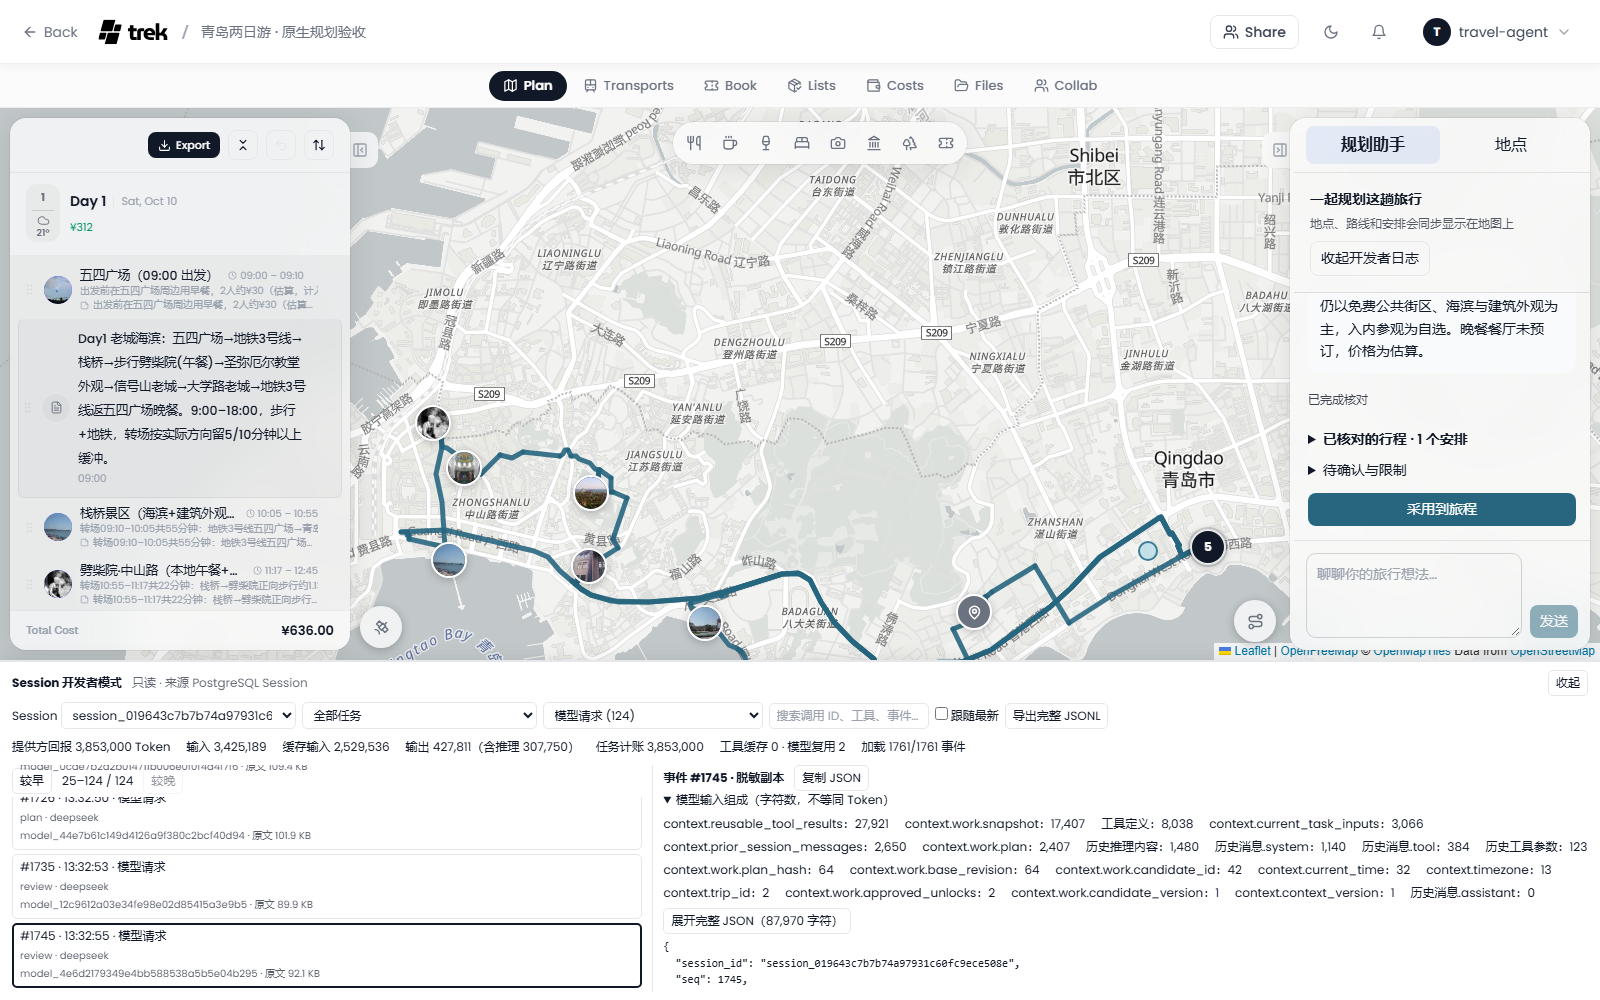
早期真实验收截图。该 Session 汇总显示 3,853,000 Token,包含多次测试与修改,不是一次规划的消耗,也不是账户完整账单。
我提供同屏抽屉和独立开发者页。先分页加载事件摘要,点击节点后才取完整详情;当前以约 1.5 秒轮询增量更新,不把它描述为 Token 流式展示。
列表和图共享阶段折叠与事件类型多选,保留阶段摘要及被隐藏的事件数量。图支持鼠标中心缩放和自由平移,刷新不抢走用户位置。“结果引用”把我带到某次调用,详情再回答模型究竟看到了什么。
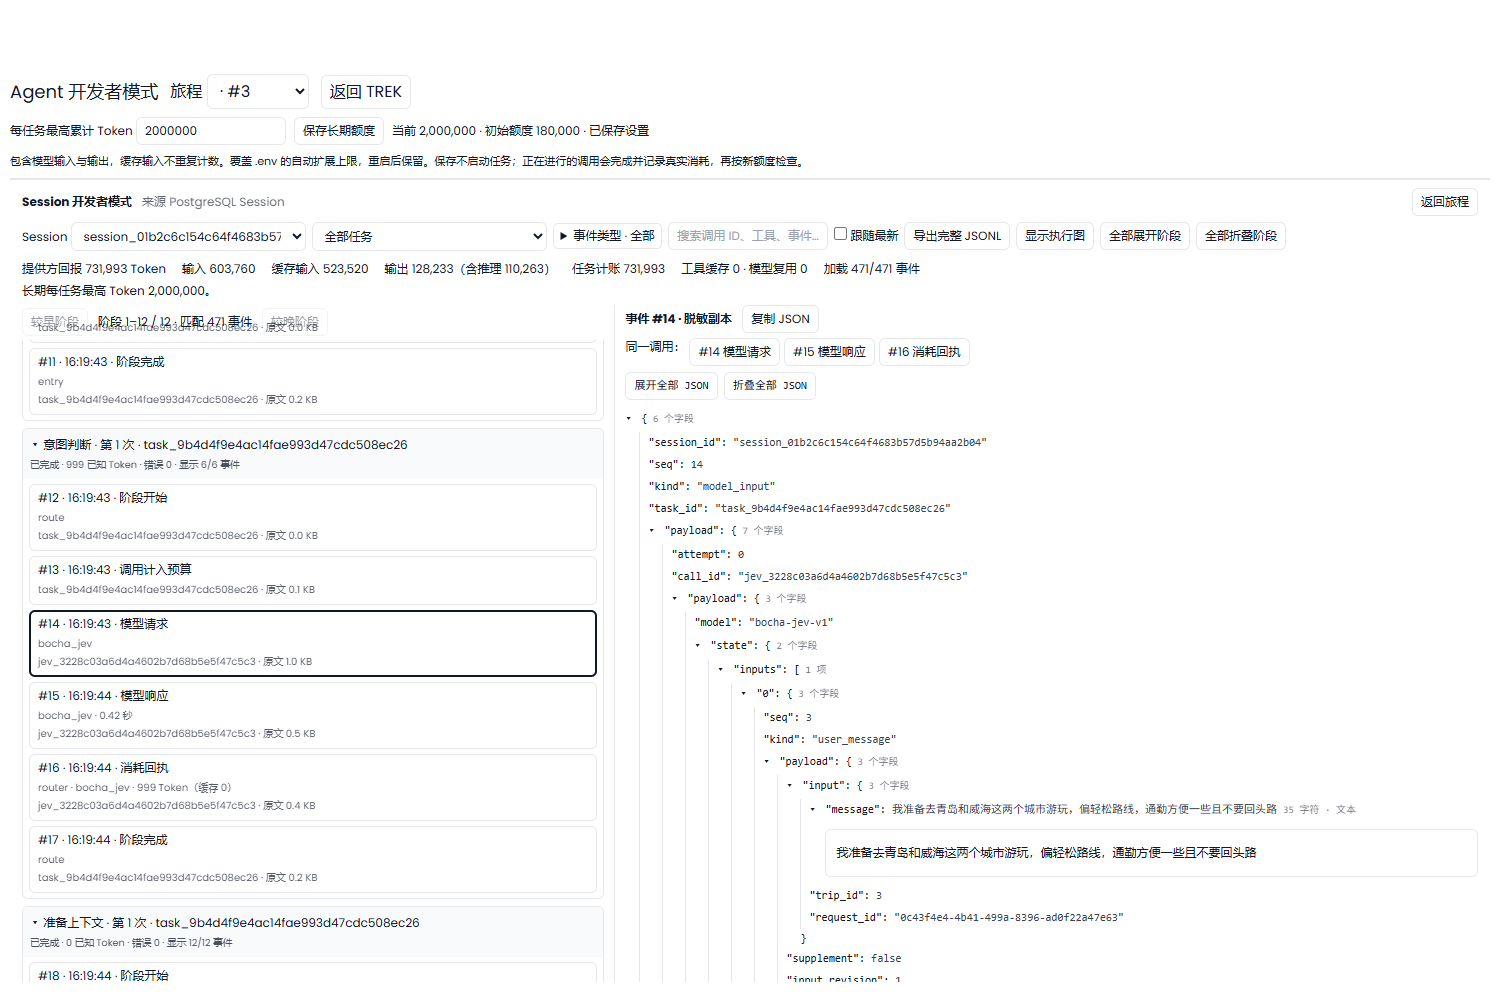
较新版本的真实 Session:同一调用可跳转请求、响应、回执;文本字段展开后按阅读格式展示。
详情把嵌套 JSON 文本解析成折叠树,把普通文本按段落和 Markdown 阅读;复制仍保留完整的脱敏事件。导出 JSONL 固定 through_seq,避免一边运行一边导出得到不清楚的边界。查看接口不触发模型调用,预算设置另走明确写入操作。
我会保留的几条底线
- 先保证记录边界,再画图。 模型最终回答不能替代工具结果与业务提交记录。
- 显示未知。 缺失用量、缺失阶段边界和被筛掉的节点,都不包装成完整成功。
- 记录多,送给模型少。 持久证据、模型上下文和 UI 摘要分别管理。
- 验证重建与交互。 幂等回执、页面变更重建、失败尝试、节点点击和缩放都需要验收。
这套 Session 不覆盖账户全部计费、独立采集/OCR 作业及所有服务器内部请求,也尚未接入统一的分布式 tracing。已有脱敏覆盖凭证类字段和配置密钥,但用户文本、地点与截图仍须按公开范围处理。
对我来说,可观测性的价值是能沿着一次失败,找到它实际看过的输入、执行过的操作、保存的版本和产生的消耗,然后做出有依据的修改。
通俗易懂,小白看了马上上手